Schadebehandeling begint met lezen
Aan het begin van een schadedossier gaat het meeste werk naar iets simpels: documenten lezen en overtypen in je systeem. Dit artikel laat zien hoe je dat leeswerk meteen bij binnenkomst doet, een collega naar de moeilijke gevallen laat kijken en de gegevens netjes in het dossier krijgt zonder over te typen.

Geschreven door
Rolf Tjalsma
Samenvatten


Een schadeclaim komt binnen als een foto van een handgeschreven aanrijdingsformulier, een garagefactuur en een paar pdf's. Voordat iemand een beslissing kan nemen, moet iemand alles doorlezen en de inhoud handmatig in het systeem typen. De allereerste stap bij elke schadeclaim is lezen.
Dat leeswerk kost veel tijd en vertraagt alles wat daarna komt. Deloitte ontdekte dat wanneer mensen digitaal konden indienen met fotografisch bewijs van de schade, de uitbetalingstijd met wel 5,5 dagen daalde. Het document zelf was niet anders. Wat veranderde, was hoe snel het kon worden gelezen en omgezet in data. De intake is waar de klok van een claim echt begint te lopen, en daarom bepaalt FNOL hoe lang een schadeclaim duurt.
Waar de dagen daadwerkelijk naartoe gaan
Bij de meeste teams gebeurt het lezen handmatig. Een claim komt binnen via e-mail, de bijlage belandt samen met tientallen andere in een gedeelde inbox, en iemand opent het, probeert te ontcijferen wat er staat, en kopieert de datum van het ongeval, de plaats, de tegenpartij en de rest veld voor veld naar het schadesysteem.
Een makelaar verwoordde het treffend:
“Het verzamelen van de administratie is ontzettend tijdrovend. Het is het deel van het vak dat de dag opslokt.”
Ze hebben zo'n zesendertig gegevens nodig om een enkel risico te dekken, en cliënten beantwoorden meestal maar ongeveer de helft van de vragen, waardoor er naast het leeswerk ook nog achter ontbrekende gegevens aan moet worden gezeten.
De documenten komen zelden perfect aan. Sommige zijn wazig. Een team vertelde ons dat hun receptie alles scant wat op papier binnenkomt, en wanneer een scan onleesbaar is, moet iemand een taak aanmaken om het origineel op te vragen voordat het dossier verder kan. Handschrift vertraagt het proces nog meer. Het ontcijferen van een handgeschreven aanrijdingsformulier is nauwkeurig werk met weinig toegevoegde waarde waar niemand om vier uur 's middags nog op zit te wachten. En het volume liegt er niet om: teams waarmee we werken verwerken honderden claims per maand met een handjevol mensen, waarbij elke claim meerdere documenten bevat. Minuten leestijd per document lopen zo op tot werkdagen per week.
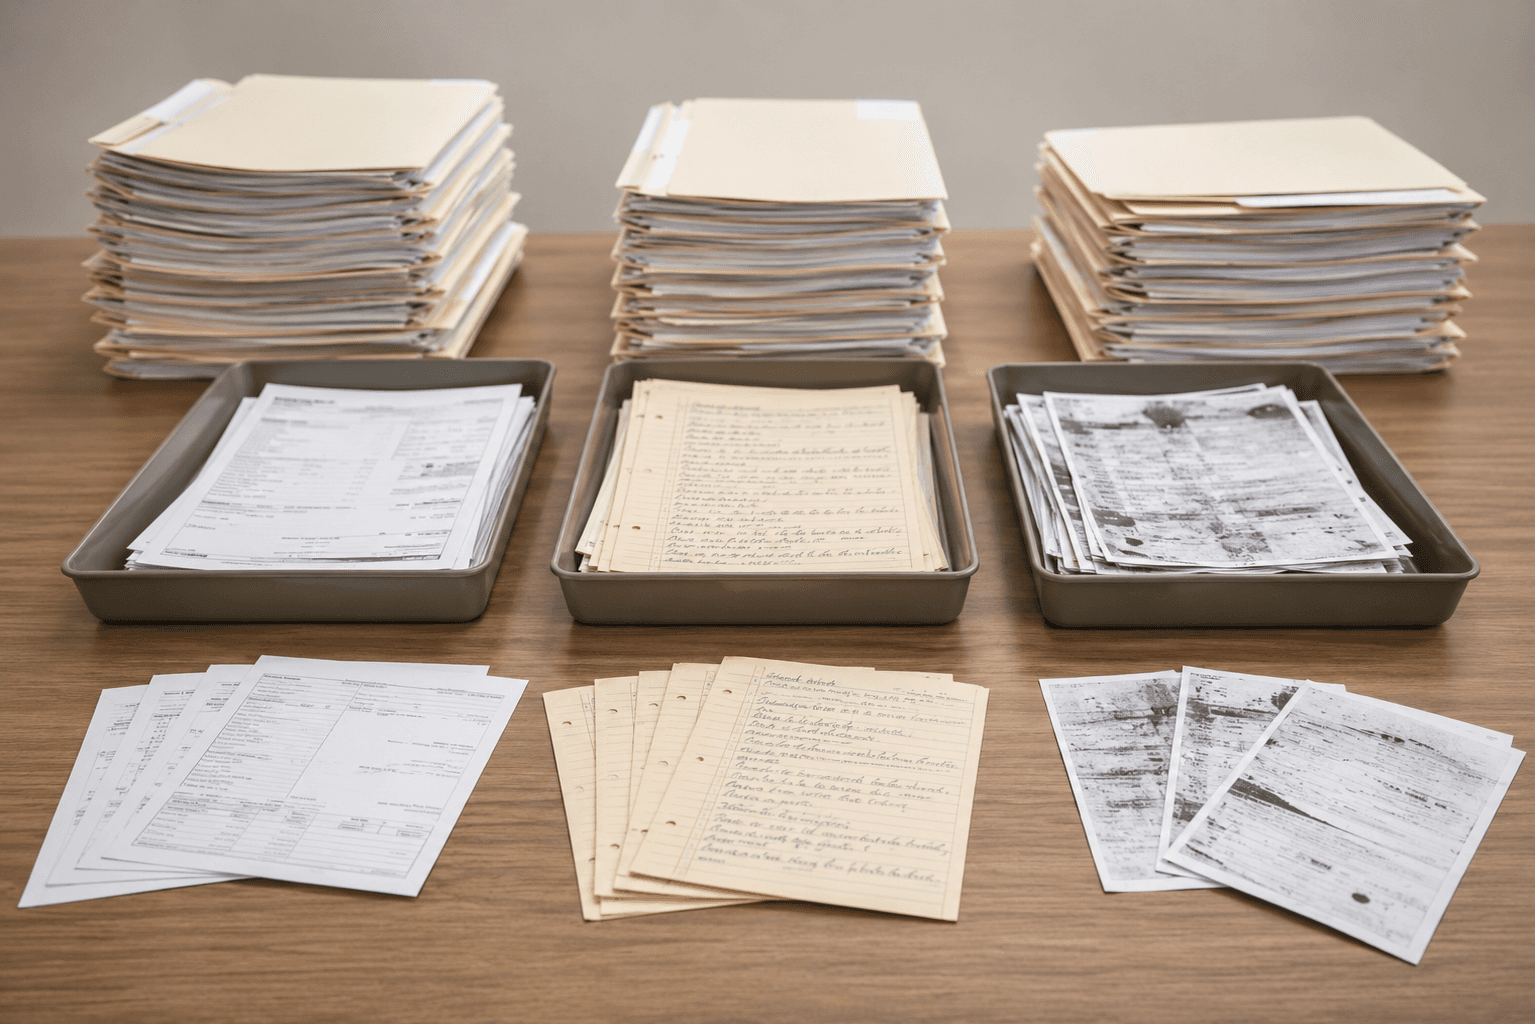
Het document is op zich prima
De eerste neiging is vaak om de klant alles opnieuw te laten invoeren in een net webformulier. Dat is de snelste manier om een half ingevuld formulier terug te krijgen, omdat u iemand vraagt een document over te typen dat ze al in handen hebben.
Een beter begin is om het document te accepteren zoals het is – de foto of de scan – en het leeswerk naar uw kant te verplaatsen, waar het goed kan worden gedaan. De klant stuurt wat hij heeft. Het omzetten naar schone data gebeurt één keer, op de juiste plek.
Eén keer lezen
Zodra het document binnen is, wordt het bij ontvangst gelezen en worden de belangrijkste velden geëxtraheerd: de datum en plaats van het ongeval, de partijen, de polis of het kenteken, de bedragen. Een net geprinte pagina is snel en goedkoop te lezen, dus de Document intelligence van Penbox voert daar een snel model op uit en de routinematige documenten stromen direct door.
De lastige documenten krijgen meer aandacht. Een handgeschreven aanrijdingsformulier, of een formulier waarbij het ene vakje alleen logisch is in combinatie met het andere, gaat naar een geavanceerder model dat de hele pagina in samenhang leest in plaats van veld voor veld. U kiest zelf welk model op welk documenttype wordt toegepast, zodat de diepere analyse alleen wordt ingezet waar het echt nodig is. De snelle en geavanceerde modellen zijn gedocumenteerd als u de details wilt bekijken.
De uitkomst wordt gecontroleerd in plaats van blindelings vertrouwd. Elk veld krijgt een betrouwbaarheidsscore mee, weergegeven naast het origineel, zodat een behandelaar het in één oogopslag kan vergelijken met de bron. Eerlijk is eerlijk: een uitlezing met een hoge score kan nog steeds fouten bevatten, zoals een ongebruikelijk gespelde naam of een e-mailadres met een verkeerde letter. Er blijft dus een mens betrokken bij stappen waar een fout gevolgen zou hebben, terwijl de vlekkeloze dossiers direct doorgaan. Een scan die te wazig is om te vertrouwen, wordt gemarkeerd, waarna er dezelfde dag nog om een betere kopie voor de claim wordt gevraagd.
Wanneer de gegevens zijn bevestigd, gaan ze rechtstreeks het dossier in. Niemand hoeft ze opnieuw in een ander scherm in te voeren. Van daaruit kan met dezelfde informatie een ontvangstbevestiging voor de klant in diens eigen taal worden opgesteld en kunnen de velden worden gevuld die uw achterliggende systeem verwacht.
Om er een concreet beeld bij te geven: stel u drie behandelaars voor die in een maand ongeveer vijftig claims verwerken, met elk twee of drie documenten. Dat zijn ruim honderd documenten om te openen en te lezen. Doordat het lezen meteen bij binnenkomst gebeurt, worden de geprinte facturen binnen enkele seconden verwerkt, komen de handgeschreven verklaringen terug met datum, plaats en partijen al ingevuld voor een snelle controle, en worden die paar onleesbare scans dezelfde dag nog teruggestuurd voor een duidelijkere kopie. Tegen de tijd dat een behandelaar een dossier oppakt, is het typewerk al gedaan.
Een waardevolle stap
Het automatisch lezen van documenten haalt de mens niet uit de schadeafhandeling, en dat zou ook niet moeten. De moeilijkste scans en de incidentele zelfverzekerde fout vragen nog steeds om iemand met verstand van zaken. Wat verandert, is de verhouding:
Uw medewerkers besteden hun dag niet langer aan documenten die iedere aandachtige lezer aankan, maar aan de gevallen die écht lastig of écht fout zijn.
Vergeleken met het handmatige startpunt is dat een logische keuze. Dat leeswerk moest sowieso gebeuren. De echte vraag is of een medewerker alles met de hand doet, of dat de tool de eerste scan doet en uw team het deel controleert dat ertoe doet. De meeste schadeteams weten al welke van de twee situaties hun werkweek omschrijft.
Penbox leest de documenten die al binnenkomen voor uw claims en slaat de gegevens op in het dossier, zodat alles op één plek plaatsvindt. Als u het grotere geheel wilt zien, leest u hier hoe een soepel schadeafhandelingsproces eruitziet en wat dossierbeheer betekent.
Vergelijkbare artikelen
Alle artikelen

Dossierbeheer
E-mailgestuurd dossierbeheer voor verzekeringsmakelaars
E-mailgestuurd dossierbeheer voor verzekeringsmakelaars: waar bestanden weglekken in een gedeelde inbox en wat een dossier moet bevatten om dit te stoppen.

Rolf Tjalsma

Bedrijfsvoering
Waarom workflowautomatisering in de verzekeringssector vastloopt op uitzonderingen
Automatisering van verzekeringsworkflows verwerkt de foutloze dossiers en plaatst de rest in een inbox. Hier lees je waar uitzonderingen vandaan komen en hoe je hiervoor ontwerpt.
Rolf Tjalsma

Bedrijfsvoering
Automatisering van verzekeringsdocumenten voor makelaars: waar het papier zich echt opstapelt
Automatisering van verzekeringsdocumenten voor makelaars, stroom voor stroom: klantdocumenten, post van verzekeraars, documentverzoeken en handtekeningen, en waar te beginnen.
Rolf Tjalsma