Traiter un sinistre, c'est d'abord lire
Au début d'un sinistre, l'essentiel du travail consiste à lire des documents et à saisir leur contenu dans votre système. Cet article explique comment faire cette lecture au fil de l'arrivée des documents, garder une personne sur les cas difficiles et obtenir des données propres dans le dossier sans ressaisie.

Écrit par
Rolf Tjalsma
Résumer


Un sinistre arrive sous la forme d’une photo d’un constat amiable rempli à la main, d’une facture de garage et de deux ou trois PDF. Avant que quiconque ne puisse décider de quoi que ce soit, quelqu’un doit tout lire et saisir ce qui est écrit dans le système. Le premier acte de chaque sinistre, c’est la lecture.
Cette lecture est lente, et elle bloque tout ce qui vient après. Deloitte a constaté que lorsque les personnes pouvaient déclarer un sinistre par voie numérique avec des preuves photo des dommages, le délai de paiement diminuait jusqu’à 5,5 jours. Le document en lui-même n’avait pas changé. Ce qui a changé, c’est la rapidité avec laquelle il a pu être lu et transformé en données. C’est à la réception que le compte à rebours d’un sinistre commence vraiment, c’est pourquoi la déclaration initiale du sinistre décide de sa durée.
Où passent réellement les journées
Pour la plupart des équipes, la lecture se fait à la main. Un sinistre arrive par e-mail, la pièce jointe atterrit dans une boîte de réception partagée avec une dizaine d’autres, et quelqu’un l’ouvre, déchiffre ce qui est écrit, puis recopie la date de l’accident, le lieu, le tiers et le reste dans le système de gestion des sinistres, champ par champ.
Un courtier l’a résumé simplement :
« La collecte des documents administratifs prend un temps fou. C’est la partie du métier qui dévore la journée. »
Ils ont besoin d’environ trente-six informations pour couvrir un seul risque, et les clients ont tendance à ne répondre qu’à la moitié de ce qu’on leur demande ; il faut donc relancer pour combler les manques, en plus de la lecture.
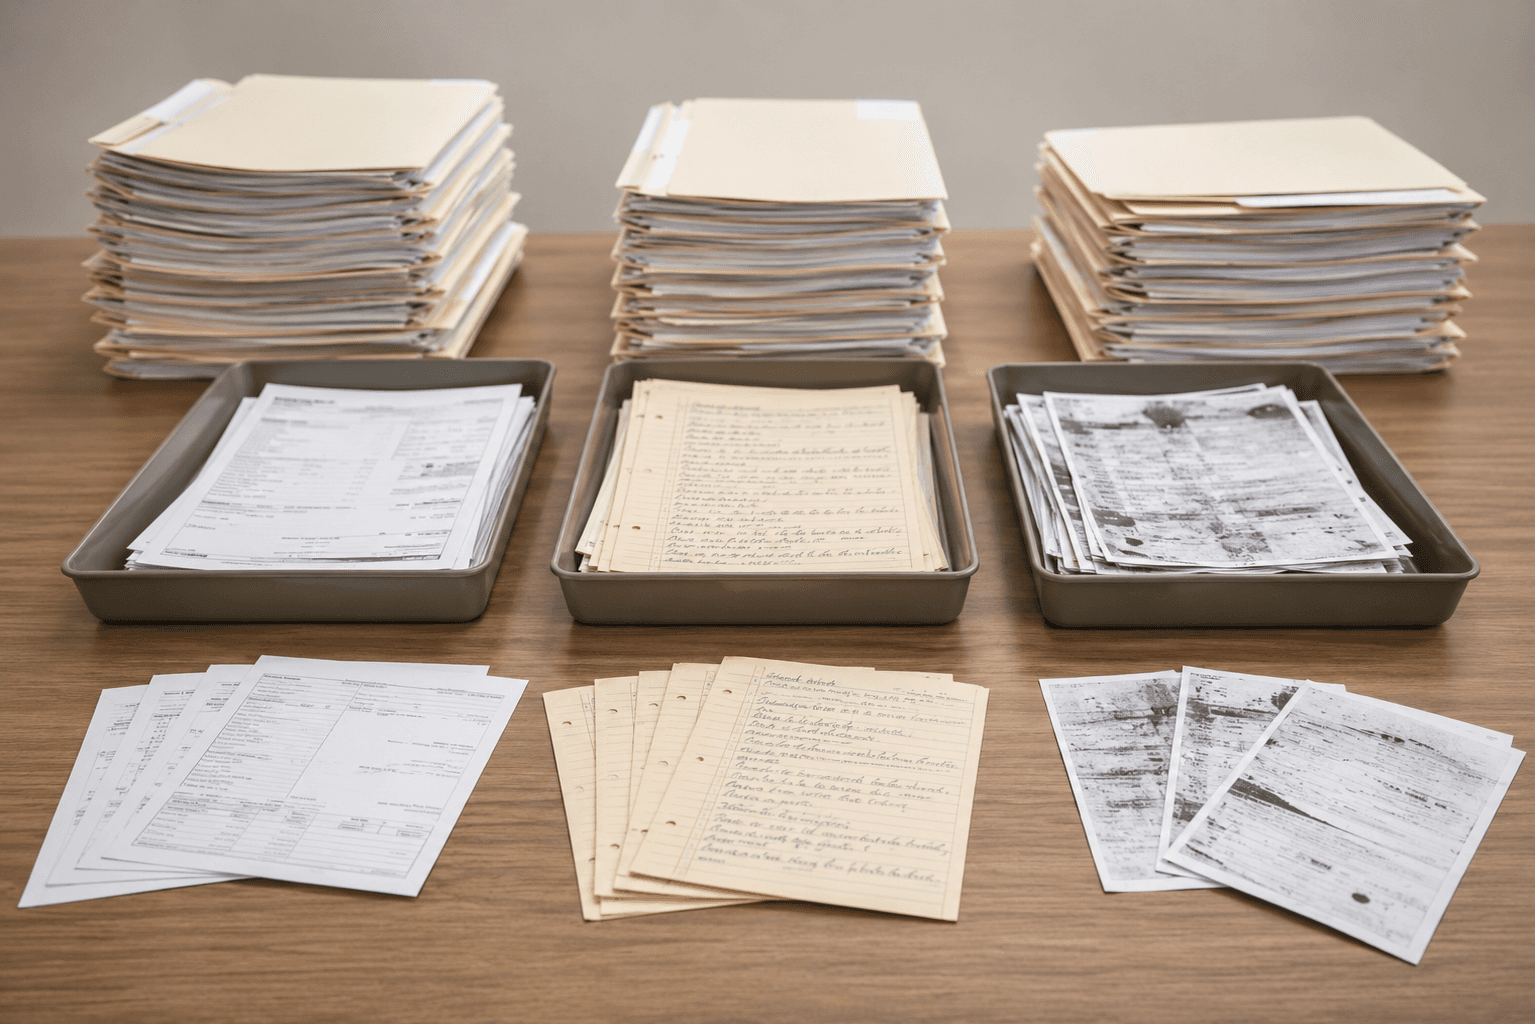
Les documents arrivent rarement impeccables. Certains sont flous. Une équipe nous a expliqué que son accueil numérise tout ce qui arrive sur papier, et lorsqu’un scan est illisible, quelqu’un doit créer une tâche pour demander l’original avant que le sinistre ne puisse avancer. L’écriture manuscrite ralentit encore le processus. Lire un constat d’accident rempli à la main est un travail minutieux, à faible valeur ajoutée, que personne n’apprécie à quatre heures de l’après-midi. Et le volume est bien réel : les équipes avec lesquelles nous travaillons traitent des centaines de sinistres par mois avec une poignée de personnes, chaque sinistre comportant plusieurs documents. Des minutes de lecture par document se transforment en journées de travail par semaine.
Le document est déjà suffisant
Le réflexe est de faire ressaisir l’intégralité au client dans un formulaire web bien ordonné. C’est le moyen le plus rapide d’obtenir une réponse incomplète, car vous demandez à quelqu’un de recopier un document qu’il a déjà sous la main.
Un meilleur point de départ consiste à prendre le document tel quel, la photo ou le scan, et à déplacer la lecture de votre côté, où elle peut être effectuée correctement. Le client envoie ce qu’il a. Le travail de transformation en données propres a lieu une seule fois, au bon endroit.
Le lire une seule fois
Dès que le document arrive, il est lu et les champs clés en sont extraits : la date et le lieu de l’accident, les parties, le numéro de police ou d’immatriculation, les montants. Une page imprimée nette est rapide et peu coûteuse à lire, c’est pourquoi la Document Intelligence de Penbox applique un modèle rapide sur ces documents, qui sont traités directement.
Les cas difficiles en demandent davantage. Un constat d’accident manuscrit, ou un formulaire où une case ne prend son sens qu’à la lumière d’une autre, est confié à un modèle plus puissant qui lit la page dans son ensemble plutôt que champ par champ. Vous choisissez quel modèle s’applique à chaque type de document, afin que la lecture approfondie ne soit utilisée que là où elle est réellement nécessaire. Les modèles rapides et avancés sont documentés si vous souhaitez en savoir plus.
La lecture est vérifiée plutôt qu’acceptée aveuglément. Chaque champ est renvoyé avec un niveau de confiance, affiché à côté de l’original afin que le gestionnaire puisse le comparer à la source en un coup d’œil. Pour être tout à fait honnête : une lecture avec un score de confiance élevé peut tout de même être erronée, un nom à l’orthographe inhabituelle ou une lettre manquante dans un e-mail. Une personne reste donc dans la boucle là où une erreur aurait un impact, tandis que les dossiers sans problème passent directement. Un scan trop flou pour être fiable est signalé, et une meilleure copie est demandée pour le sinistre le jour même.
Une fois la lecture confirmée, les données sont injectées directement dans le sinistre. Personne ne les saisit à nouveau dans un autre écran. De là, les mêmes informations permettent de rédiger l’accusé de réception pour le client dans sa langue et de renseigner les champs attendus par votre système en aval.
Pour donner un ordre de grandeur : imaginez trois gestionnaires traitant environ cinquante sinistres par mois, avec deux ou trois documents chacun. Cela fait bien plus de cent documents à ouvrir et à lire. Avec une lecture effectuée dès l’arrivée, les factures imprimées sont traitées en quelques secondes, les constats manuscrits reviennent avec la date, le lieu et les parties déjà préremplis pour une vérification rapide, et la poignée de scans illisibles fait l’objet d’une demande de copie plus claire le jour même. Lorsqu’un gestionnaire prend en charge un sinistre, la saisie est déjà faite.
Un compromis qui en vaut la peine
Lire automatiquement les documents n’exclut pas l’humain de la gestion des sinistres, et ce ne devrait pas être le cas. Les scans les plus difficiles et les rares erreurs à score de confiance élevé nécessitent toujours l’intervention de personnes du métier. Ce qui change, c’est la proportion :
Vos collaborateurs cessent de passer leur journée sur des documents que n’importe quel lecteur attentif pourrait traiter, pour se consacrer à ceux qui sont véritablement complexes ou qui comportent de réelles erreurs.
Par rapport au traitement manuel de référence, le choix est vite fait. La lecture devait de toute façon avoir lieu. La vraie question est de savoir si une personne fait tout à la main, ou si l’outil effectue la première passe et que votre équipe vérifie la partie essentielle. La plupart des équipes de gestion des sinistres savent déjà quelle option décrit leur quotidien.
Penbox lit les documents que vos sinistres reçoivent déjà et inscrit les données dans le dossier, centralisant ainsi tout au même endroit. Pour avoir une vue d’ensemble, découvrez à quoi ressemble un processus de gestion des sinistres performant et ce que signifie le dossier management.
Articles similaires
Tous les articles

Gestion des dossiers
Gestion de dossiers pilotée par e-mail pour les courtiers d'assurance
Gestion de dossiers pilotée par e-mail pour les courtiers d'assurance : où les dossiers fuient dans une boîte de réception partagée et ce qu'un dossier doit contenir pour y remédier.

Rolf Tjalsma

Opérations
Pourquoi l'automatisation des flux de travail dans l'assurance échoue face aux exceptions
L'automatisation des flux de travail dans l'assurance traite les dossiers sans anomalie et dépose le reste dans une boîte de réception. Voici d'où viennent les exceptions et comment concevoir vos processus pour les gérer.
Rolf Tjalsma

Opérations
Automatisation des documents d'assurance pour les courtiers : là où la paperasse s'accumule vraiment
Automatisation des documents d'assurance pour les courtiers, flux par flux : documents clients, courriers des assureurs, demandes de documents et signatures, et par où commencer.
Rolf Tjalsma